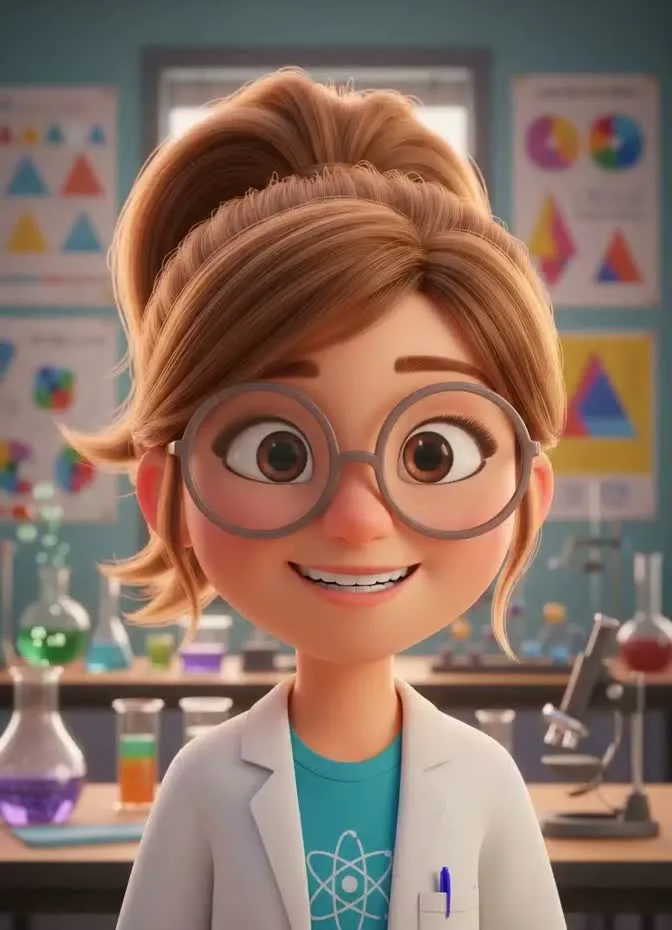
卡通科学家:原图
正面角色的嘴部清晰可见,适合用作说话视频的输入参考。
照片说话需要一张清晰人像和一段声音。你可以上传音频、直接录音,或输入文字让预设音色朗读,再生成口型随声音变化的视频。只用本人或已获授权的照片和音频,分享时说明是 AI 生成,不用它冒充他人或伪造真实发言。
MP3、WAV、M4A 或 OGG,最大 10 MB,时长须超过 1 秒且不超过 60 秒。“丰富表情”要求短于 60 秒。
这是参考示例,不是用你上传的素材生成的结果。
AI 根据照片里的面部和音频节奏生成嘴部、下颌、眨眼及轻微头部动作。视频内容来自你提供的声音,不是找回照片拍摄时的原声,也不代表照片里的人真的说过这些话。
声音可以来自文件、浏览器录音,或文字转语音。文字方式提供 8 种预设音色,不会学习或复制照片中人物的声音。
每组包含原图和生成视频。点卡片会选中对应模型,示例仅供参考;图片和音频需自行上传。
正面角色的嘴部清晰可见,适合用作说话视频的输入参考。
眉毛和头部随语音变化,让卡通角色的讲解更生动。
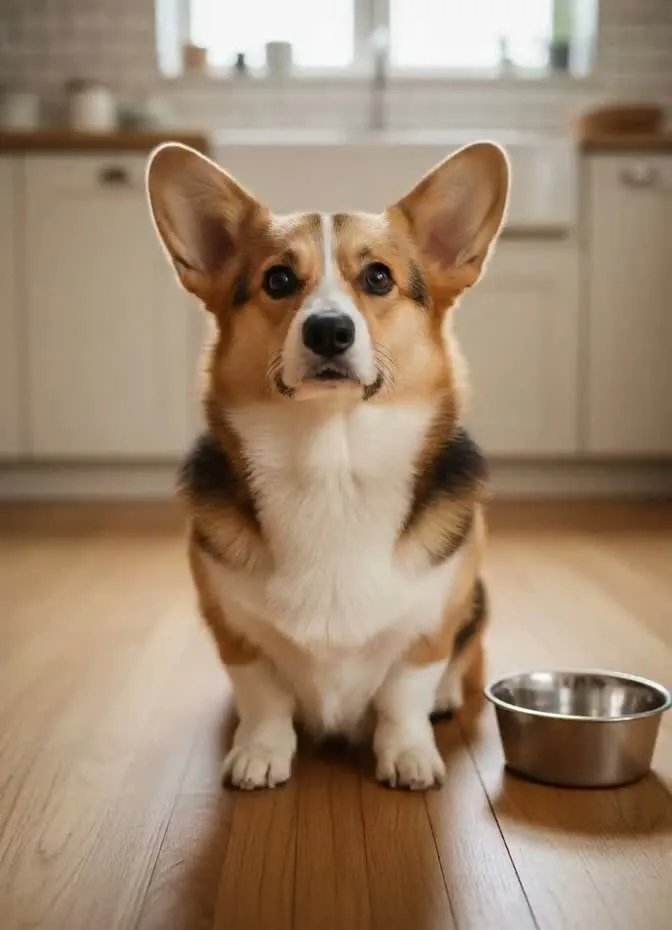
平视拍摄,口鼻完整清晰,便于观察嘴部变化。
示例给柯基配上晚饭迟到的抱怨。短句更容易听清,也更适合轻松的宠物配音。
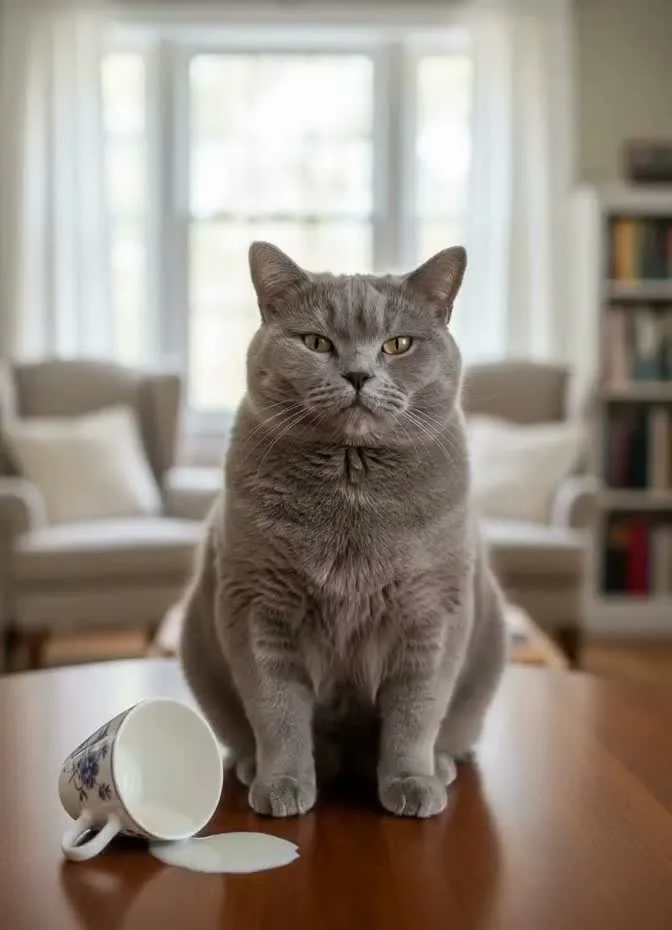
正面拍摄的灰猫,旁边有一个打翻的杯子。
用一句短短的解释制造趣味,不把配音当成动物真实表达。
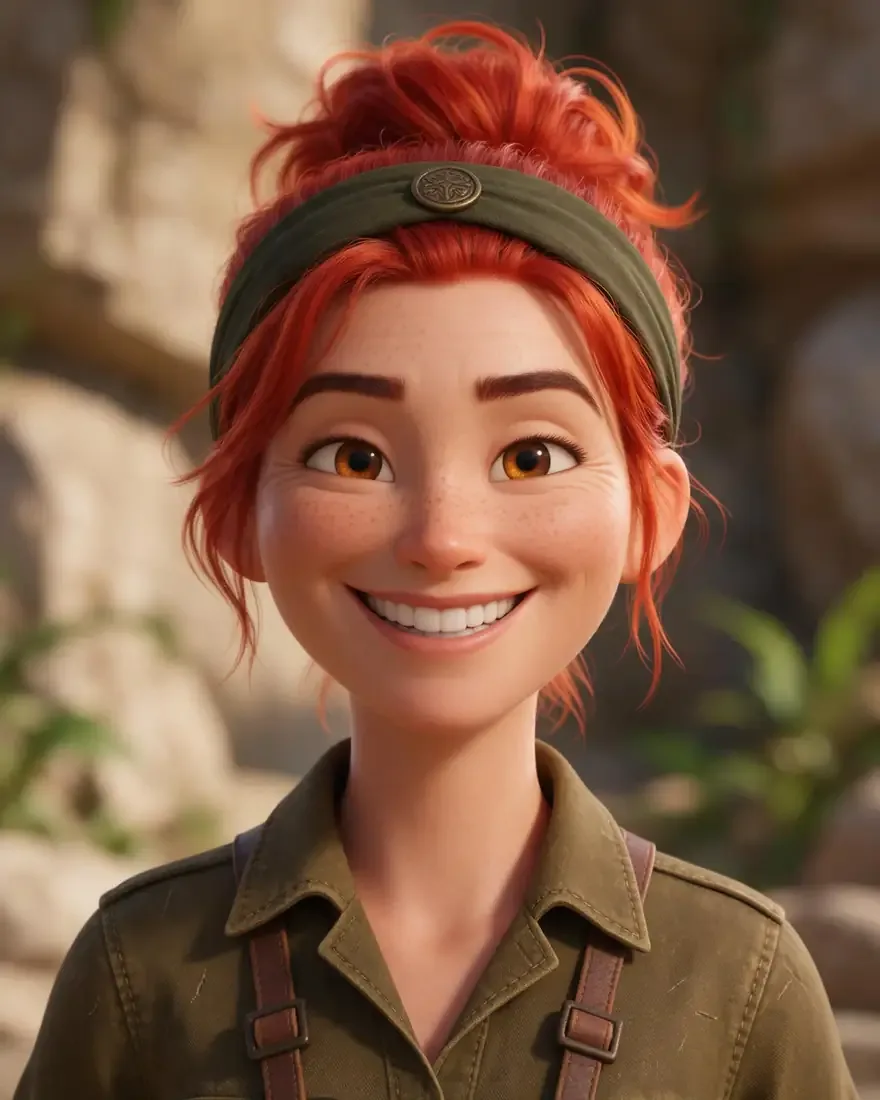
原创 3D 角色轻微侧身,嘴部仍清晰可见。
让原创角色开口介绍自己,可作为故事或角色展示片段。
操作区支持手机和电脑浏览器。请先确认人物和声音都获得授权。
支持 JPG、PNG,最大 10 MB。请用清晰的成年人人像,尽量正面或轻微侧脸,嘴部无遮挡。
选择“上传音频”“录音”或“输入文字”。音频支持 MP3、WAV、M4A 或 OGG,最大 10 MB,时长超过 1 秒且不超过 60 秒。文字最多 1000 字符,先点击“生成说话音频”并试听。
“标准 720p”和“专业 1080p”适合普通口播;“丰富表情”输出 1080p,侧重更活跃的动作,音频须短于 60 秒。“动作描述(选填)”可补充点头或手势要求。
勾选本人或已获许可的确认项,点击“生成视频”。完成后打开声音,核对口型、内容和面部细节再下载。
先选择“录音”,在安静环境里录一段介绍或感谢话。浏览器会请求麦克风权限,录好后先试听,再搭配照片生成。
上传自己有权使用的人声音轨,让照片跟随演唱节奏。清唱或背景较轻的人声更容易辨认,伴奏太响、多人同时唱会影响口型。
选择“丰富表情”,用上半身和手部入镜的照片,在“动作描述(选填)”里写“抬起一只手,再轻轻点头”等要求,最多 300 字符。动作可能不完全按描述发生,手指也需要检查。
使用自己创作或已获许可的作品,面部正向且嘴部清晰。“专业 1080p”提供较高输出分辨率,但不能保证笔触、珠饰和布料细节完全不变。
人物说出的内容由你提供,分享时应说明是生成视频。
用自己的照片和声音做简短介绍,发布前检查台词和生成后的表情。
用本人或原创角色介绍课程内容,不冒用他人形象和身份。
使用已获本人许可的照片做祝福;宠物视频可配简短趣味台词。
给自有角色配一段台词,帮助表达角色气质,不必把它当作最终动画成片。
先用短音频测试,再考虑更长的脚本。
极端角度会遮住部分嘴部,尽量让两侧嘴角清晰可见。
手、头发和麦克风遮住嘴时,模型需要猜测更多细节。自然闭嘴的原图通常比夸张大笑更容易处理。
靠近麦克风,减少回声、背景音乐和多人同时说话,让语音更清晰。
正常说话并留少量停顿,过快的语速或长时间空白可能让口型不协调。
先用一句短话检查表情和手势,确认人物动作自然后,再处理较长的脚本。
使用本人或明确获许可的照片和声音,不用生成内容冒充真实录音、代言或个人立场。
是一段从静态照片和音频生成的视频,嘴部、眼睛和头部会配合声音运动。它不是真实拍摄记录,也不代表原照片人物当时说过这些内容。
上传清晰图片,添加音频或先把文字生成语音,选择模型并确认人物许可,最后点击“生成视频”。完成后带声音检查,再下载和分享。
可以尝试“丰富表情”,并用手部和上半身入镜的照片。在“动作描述(选填)”中写出简短要求,生成动作不保证完全照做,手部细节尤其需要检查。
“标准 720p”适合先试基本口播;“专业 1080p”输出分辨率较高;“丰富表情”同样输出 1080p,侧重更活跃的表情和动作。具体积分在“生成视频”按钮上显示。
需要。视频生成按所选模型和音频时长消耗积分,开始前“生成视频”按钮会显示所需数量。若使用“输入文字”,生成说话音频也单独消耗积分,音频按钮会显示所需积分。注册即送 100 积分;首次购买任意套餐或积分包后,这些积分会解锁并永久有效。
可以尝试,示例包含宠物、3D 角色和肖像画。“丰富表情”适合尝试这类形象,但嘴部需清晰可见,效果不保证和真人相同。画作和角色图也应有使用许可。
可以尝试清晰的人像,但不要把配音当成原人物真实说过的话。人物肖像和音频都须有适当授权,模糊、遮挡或过小的人脸会影响效果。
视频时长取决于音频。所有模式的音频都要超过 1 秒;“标准 720p”和“专业 1080p”最长支持 60 秒,“丰富表情”需短于 60 秒,正好 60 秒的音频要先剪短。文字生成的语音也须符合所选模式的时长限制。
不用。本页在浏览器里操作,录音需要麦克风权限。若设备或浏览器不能录音,可改为上传符合要求的音频文件。
可以上传自己的中文录音。文字方式使用预设音色,具体发音应先试听;本页不提供声音克隆,也不会根据一张照片推断人物原声。
需要明确说明是 AI 生成。只使用本人或已获授权的照片和音频,不用于冒充、欺骗、骚扰或伪造真实发言。
选清晰人像,录一段声音,生成后检查口型和表情。
照片说话输出为 AI 生成视频,不是真实录音录像。只上传本人或已获授权的照片和音频,不冒充他人,也不用于欺骗、骚扰或伪造发言。分享时请明确标注 AI 生成。