飞船降临城市
巨型飞船、蒸汽和向上抬升的镜头,展示科幻场景中的重量感。
万相 2.2 是阿里通义万相团队的开源视频模型。这里使用 A14B Turbo:用文字构思场景、让一张照片动起来,或给人像配一段语音,生成约 5 秒的短片。在线操作即可,不需要准备显卡。
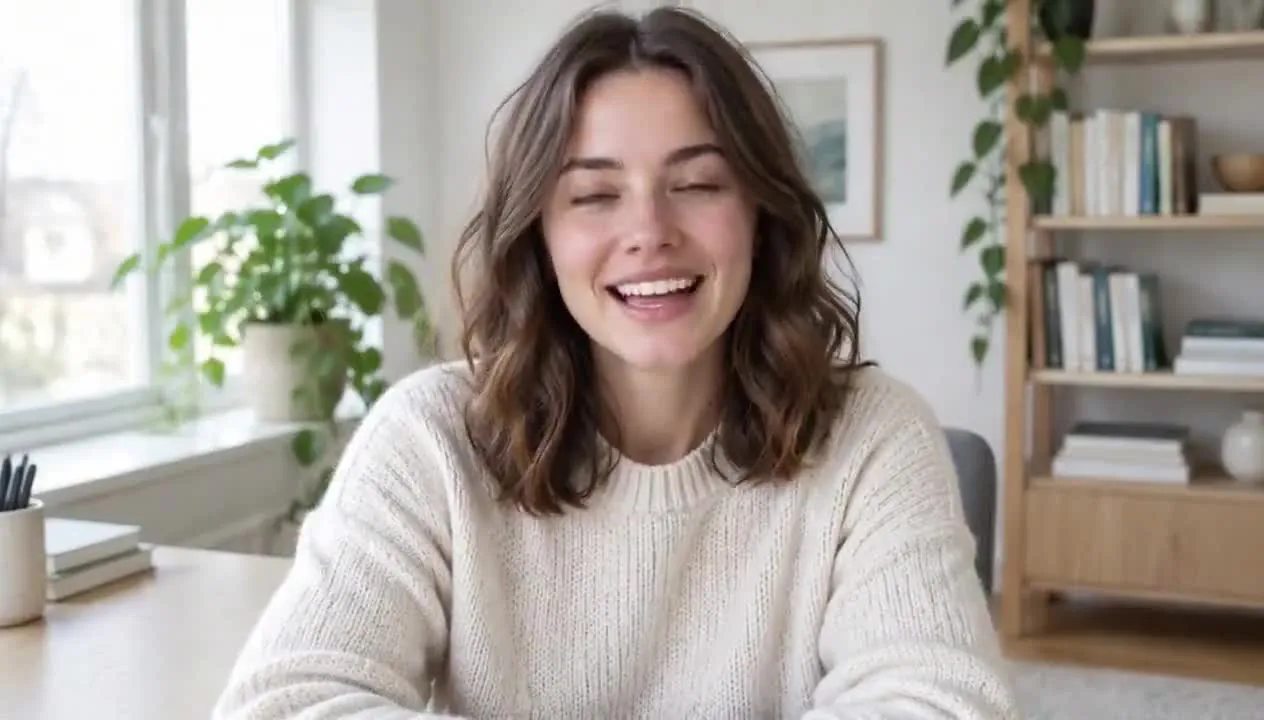
A kind-faced old man, wearing a straw hat and overalls, stands in a sunny vegetable garden. He is holding a ripe tomato and is very happy, his eyes shining with pure happiness.
这是参考示例。
万相 2.2 是 2025 年 7 月发布的阿里开源视频模型,采用 Apache 2.0 许可。它用混合专家架构分工处理场景布局和细节:总参数为 270 亿,每一步激活约 140 亿。和上一代相比,训练中增加了图片、视频以及光线、构图和色彩相关标注。
本页提供托管的 A14B Turbo,分为文生视频、图生视频和语音驱动视频(Wan 2.2 S2V)。片长约 5 秒,文生视频和图生视频输出 480p 或 720p 无声片段,语音驱动视频另有 580p,可让口型跟随录音。需要更长片段、1080p、生成声音或多份参考素材时,可查看“通义万相 Wan 3.0”。
先按输入素材选择模式,再看分辨率和比例。
| 项目 | 文生视频 | 图生视频 | 语音驱动视频 |
|---|---|---|---|
| 输入 | 提示词 | 照片和提示词 | 人像、语音和提示词 |
| 分辨率 | 480p 或 720p | 480p 或 720p | 480p、580p 或 720p |
| 画面比例 | 16:9 或 9:16 | 跟随照片,必要时缩放并居中裁剪 | 跟随照片 |
| 片长 | 约 5 秒 | 约 5 秒 | 约 5 秒,16 fps、80 帧 |
| 声音相关功能 | 无声 | 无声 | 口型跟随上传的语音 |
| 扩写提示词 | 可选 | 可选 | 不支持 |
| 上传限制 | 无需上传 | JPG、PNG 或 WebP,最大 10 MB | 图片及 MP3、WAV、M4A、AAC、OGG 或 FLAC 音频,每个文件最大 10 MB |
本页不提供更长视频、1080p、生成声音、尾帧或参考视频输入;这些需求可查看“通义万相 Wan 3.0”的选项。
2.2 适合用较少积分试短动作,3.0 提供更多时长和素材设置。
| 项目 | Wan 2.2(本页) | Wan 3.0 |
|---|---|---|
| 用途 | 5 秒草稿、照片动态和人像说话 | 带声音和参考素材的较长片段 |
| 输入 | 文字、单张照片,或人像加语音 | 文字、首尾帧;模型上限 10 张图、5 段视频、5 段音频,本站对应页面提供 3 张图、1 段视频和 1 段音频 |
| 片长 | 约 5 秒 | 2–30 秒 |
| 分辨率 | 480p、720p;语音驱动视频另有 580p | 480p、720p、1080p |
| 比例 | 文生视频:16:9、9:16 | 自动、16:9、4:3、1:1、3:4、9:16 |
| 生成声音 | 不支持 | 支持,可开关 |
Wan 2.2 的模型采用 Apache 2.0 开源许可;这里提供在线托管使用,生成任务仍消耗积分。
点卡片会把对应设置填进上方操作区,示例图仅供参考。
巨型飞船、蒸汽和向上抬升的镜头,展示科幻场景中的重量感。
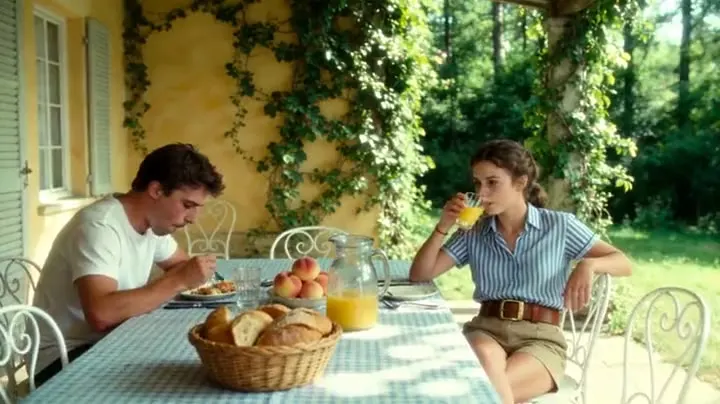
跟拍车辆、扬尘和逆光,把一个明确动作放进约 5 秒片长。
老人把番茄举向镜头。图生视频以原照为基础,生成后仍需核对人物和菜园细节。
用阴天光线、低机位、中近景和冷色调描述具体镜头要求。
卧室里的商品展示模拟生活化拍摄,适合先检查手势和构图。
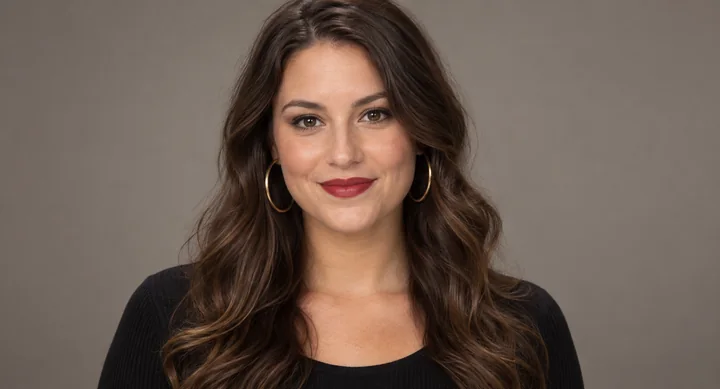
上传这类清晰正面照,再配一段语音,让嘴部、面部和头部随录音变化。
准备好素材后,在浏览器里完成三步操作。
选“文生视频”填写场景;选“图生视频”上传起始图片;选“语音驱动视频”上传人像和录音。提示词写清希望出现的动作。
用 480p 检查草稿,需要更清晰时可选 720p。文生视频可选横屏或竖屏;可开启扩写提示词补充细节。
查看“用万相 2.2 生成视频”按钮上的积分后提交。完成后检查人物、动作和取景,下载保存,或只调整一项要求再生成。
模型分工、摄影要求、照片动作和人像配音,下面各举一例。
模型先处理布局和动作,再细化纹理和面部。总参数 270 亿、每步激活约 140 亿,这种分工让它能处理更复杂的场景。
可写日落暖光、轮廓光、低机位、中近景、缓慢推进等要求。比只说“电影感”更容易表达想要的光线和构图。
以人物、商品或风景照片为起点,写转头、抬手、光线移动或缓慢运镜。不要同时要求太多动作,完成后检查主体外观。
Wan 2.2 S2V 让嘴部、面部和头部随说话或唱歌录音变化,可用于简短介绍或口型测试,提供 480p、580p 和 720p。
制作风景、空镜或过渡画面,放进自己的剪辑;对外使用时说明 AI 生成来源。
用一张商品照片尝试环绕镜头或日常使用场景,检查外观是否保持准确。
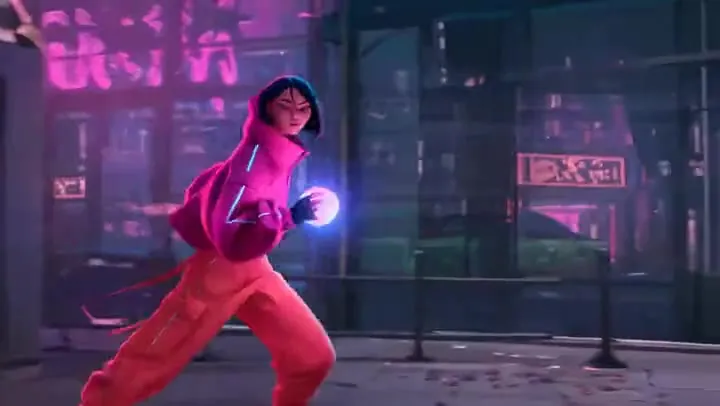
先确定赛璐珞、3D 动画或绘画风格,再安排一个清楚的动作。
用获准使用的人像和录音尝试一句介绍、角色台词或唱歌片段。
正式拍摄前检查镜头移动、光线和人物走位,再决定是否制作更长片段。
先写机位和光线,再写主体、环境和一个动作。
例如日落暖光、低机位、中近景、冷色调,再补充人物和场景。
约 5 秒适合转身、倒水或缓慢推镜。动作和镜头越集中,越方便判断结果。
想要动漫、3D 动画或水彩质感时,先写画风,再说明动作。
图生视频和语音驱动视频已提供人物外观,可把文字留给动作、表情和镜头变化。
了解输入素材、视频规格和在线使用方式。
它是阿里通义万相团队在 2025 年 7 月发布的开源视频模型。这里通过托管的 A14B Turbo,提供文字、图片和语音驱动 3 种用法。
需要。所需积分按输入模式和分辨率计算,开始前“用万相 2.2 生成视频”按钮上会显示具体数量。注册即送 100 积分;首次购买任意套餐或积分包后,这些积分会解锁并永久有效。
不能。本页输入是文字、照片,或人像加语音。让静态图片动起来时,上传起始图片并描述动作即可。
选择语音驱动视频,上传清晰人像和说话或唱歌录音,再写简短动作要求。结果约 5 秒,提供 480p、580p 或 720p,口型和头部动作会参考录音。
每段约 5 秒。文生视频支持 16:9 和 9:16;图生视频和语音驱动视频跟随照片比例,必要时会缩放或居中裁剪。文生视频和图生视频支持 480p 和 720p。
2.2 适合短动作草稿。3.0 支持 2–30 秒、最高 1080p、生成声音、首尾帧以及图片、视频和音频参考。按自己的输出要求选择即可。
不需要。在这里上传素材、填写提示词并提交即可,由在线服务完成生成。
本页使用 API 服务商提供的 A14B Turbo,分别处理文字、图片和语音驱动任务。其他托管版本或社区修改版不属于本页选项。
开源许可不代表在线计算无需成本。本站提供托管生成,运行模型需要计算资源,因此按当前模式和分辨率消耗积分。
EzImgMaker 是独立服务,通过第三方 API 服务商接入该模型,和阿里或万相团队没有关联,也没有获得其背书或赞助。
请使用自己拥有或已获授权的素材,涉及他人的面部或声音应先取得同意。不要制作冒充真实当事人的误导内容。
写一个场景、上传一张照片,或给人像配一段语音,再选择合适的分辨率。
Wan 和通义万相是阿里巴巴集团或其关联公司的商标。EzImgMaker 是独立服务,和上述公司没有关联,也没有获得其背书或赞助。